완성하고 검증한 결과만 공개하라
2026년 10월
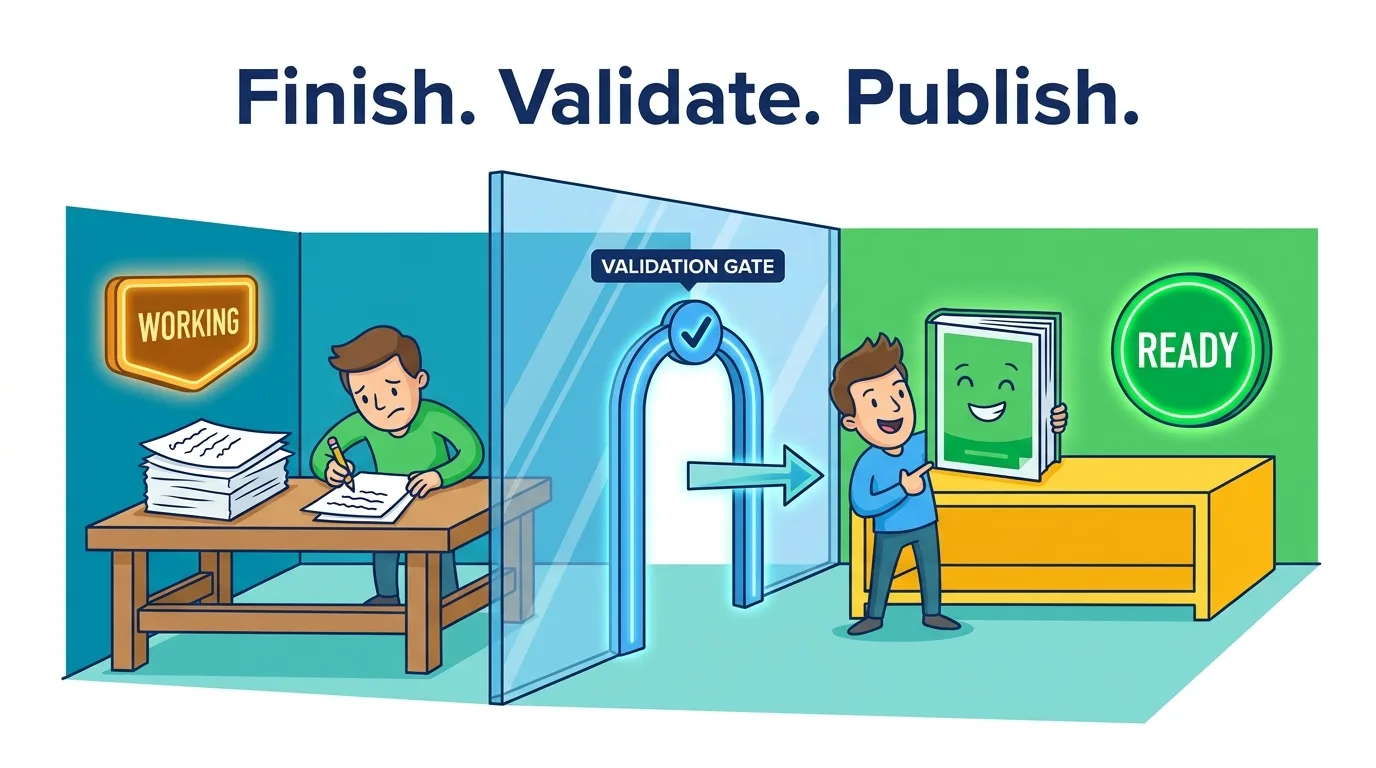
작업 중인 결과와 사람들이 쓰는 결과를 분리하고, 새 결과가 검증을 통과한 뒤에야 공개 지점을 바꾼다.
반쯤 저장된 보고서
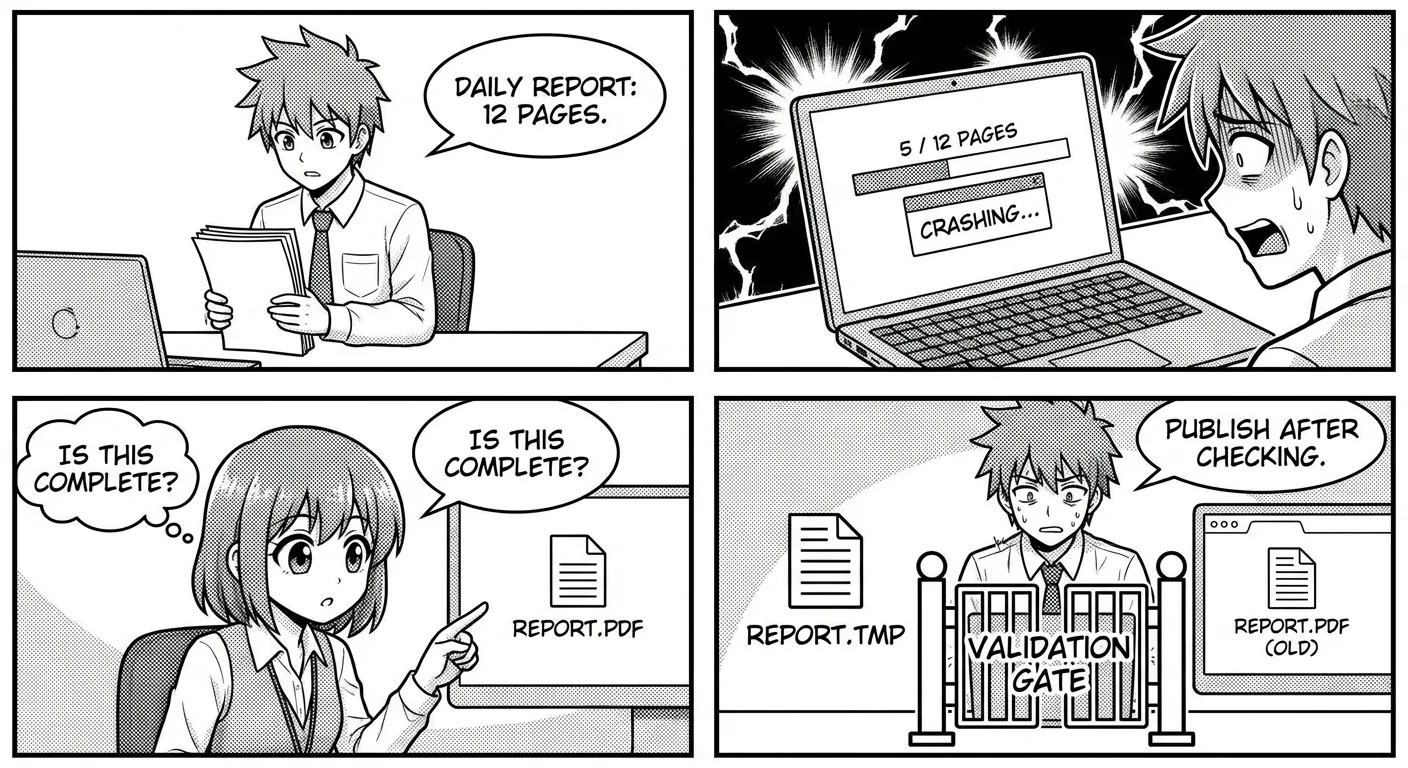
매일 아침 스크립트가 12쪽짜리 보고서를 report.pdf에 쓴다. 어느 날 5쪽에서 죽는다. 파일 이름도, 위치도, 시간도 평소와 같다. 동료가 파일을 열어 5쪽을 보고 그게 최종본이라고 믿는다. 파일 어디에도 미완성이라는 표시는 없다.
문제는 스크립트가 죽은 게 아니다. 죽는 일은 생긴다. 문제는 스크립트가 독자가 여는 바로 그 파일에 직접 썼다는 것이다. 그래서 독자가 작업 중인 상태를 볼 수 있었다.
| 저장 방식 | 중간에 실패했을 때 독자가 보는 것 |
|---|---|
| 최종 파일을 직접 수정 | 반쪽 결과, 또는 손상된 파일 |
| 임시 파일에 쓰고 검증한 뒤 교체 | 어제의 완성본 |
두 번째 방식도 완벽하진 않다. 어제 보고서는 낡았다. 하지만 낡았어도 완성된 결과는 독자가 판단할 수 있다. 반쪽인데 표시도 없는 결과는 판단할 수 없다.
계산과 공개를 두 단계로 나눈다
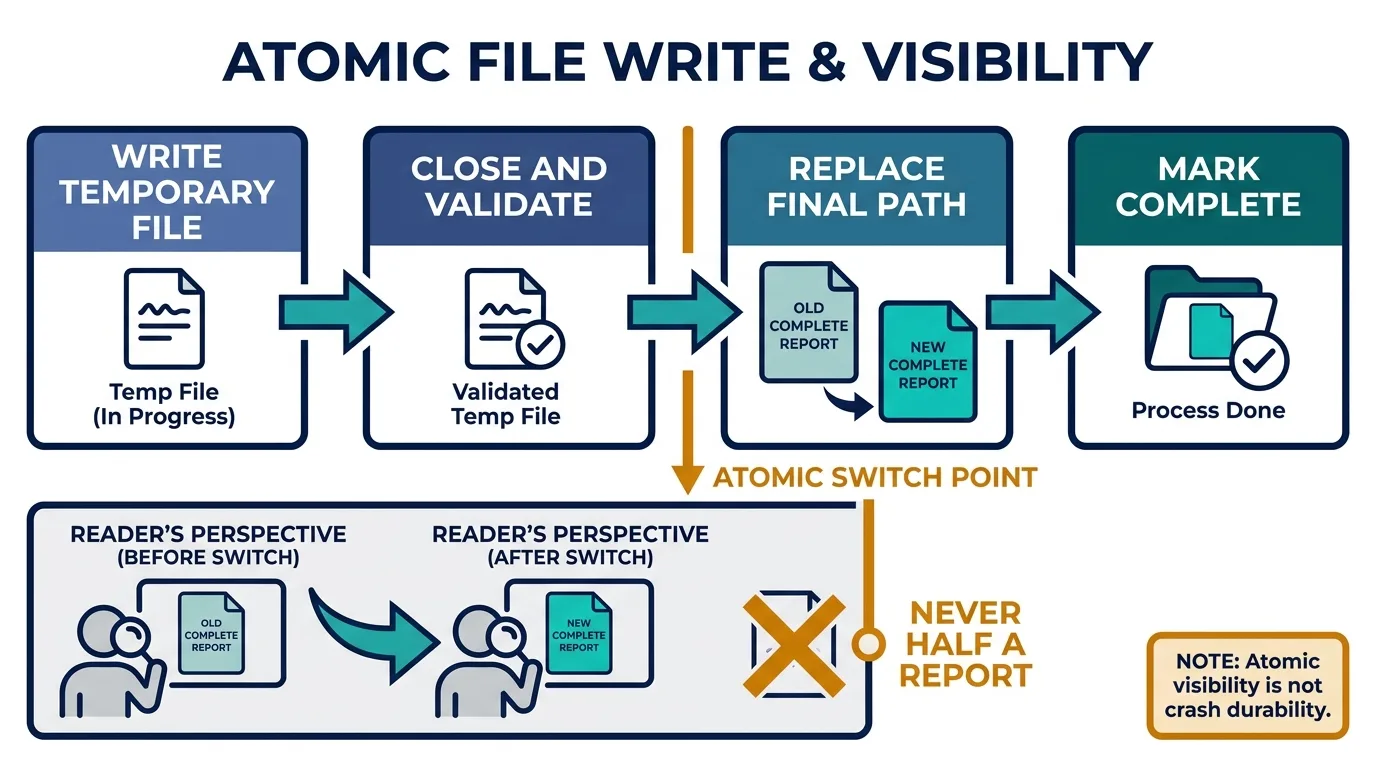
해법은 한 단계를 둘로 쪼개는 것이다.
- 같은 파일시스템에 있는 임시 파일에 새 결과를 쓴다.
- 파일을 닫고 다시 읽어서 검사한다. 형식이 맞는지, 필수 내용이 있는지, 건수가 예상과 같은지.
- 검사를 통과했을 때만 최종 경로를 임시 파일로 교체하고, 완료 상태를 기록한다.
Python의 os.replace는 성공하면 이름 교체를 원자적으로 해낸다. 그 경로를 여는 독자는 이전 파일이나 새 파일 중 하나만 보고, 둘이 섞인 상태는 보지 않는다. 다만 파일시스템이 다르면 실패할 수 있어서, 1단계에서 같은 파일시스템을 쓰라고 한 것이다 (Python 문서).
여기서 헷갈리기 쉬운 두 성질이 있다. 원자성은 독자에게 중간 상태를 숨긴다. 내구성은 전원이 나가도 저장이 남는 것을 보장하는데, 이건 OS와 저장장치가 올바른 순서로 디스크에 내려써 줘야 성립한다 (SQLite, Atomic Commit). 이름 교체가 주는 건 앞의 것이다. 뒤의 것은 그것만으로 생기지 않는다.
코드로 보면: 작업 폴더와 공개 폴더
폴더를 둘로 나눈다. 작업과 검증은 work/에서 하고, 분석가는 publish/만 본다. 계산이 죽거나 검증에 실패해도 publish/에는 어제의 완성본이 그대로 있다.
실무에서 자주 보는 패턴이고, 나도 많이 쓴다. 통하는 이유는 cp가 앞의 비싼 계산보다 훨씬 빨리 끝나서, 반쪽 파일이 보일 수 있는 시간이 짧기 때문이다. 짧을 뿐 0은 아니라서, publish/ 안의 임시 이름으로 복사한 뒤 이름만 바꾼다.
cd publish
cp ../work/report.csv .report.csv.tmp \
  && mv .report.csv.tmp report.csv
def publish(draft, out):
    validate(draft)  # 실패 시 멈춤
    tmp = out / f".{draft.name}.tmp"
    shutil.copyfile(draft, tmp)
    os.replace(tmp, out / draft.name)
mv와os.replace는 같은 파일시스템 안에서만 원자적이다. 그래서 임시 파일을publish/안에 둔다.
데이터 파이프라인에서: 메달리온 구조
Databricks의 메달리온 구조(medallion architecture)도 같은 생각이다. 데이터를 세 층으로 나눠 단계마다 품질을 올리고, 분석가에게는 마지막 층만 보여 준다 (Databricks 문서).
| 이 노트 | 메달리온 구조 |
|---|---|
work/에서 계산 |
Bronze: 원천 데이터를 정제 없이 그대로 받는다 |
| 검증 | Silver: 정제하고 검증한다 |
publish/만 읽는 분석가 |
Gold: 분석가와 BI가 읽는 테이블 |
os.replace로 이름 교체 |
Delta 커밋: 트랜잭션이 끝나기 전까지 독자는 이전 버전을 본다 |
- 층을 나누는 것만으로는 원자성이 생기지 않는다. 층은 품질을 단계별로 올리는 장치이고, Gold 테이블이 반쯤 쓰인 채로 보이지 않는 건 Delta Lake의 트랜잭션 덕분이다. 트랜잭션은 전부 성공하거나 전부 실패한다 (Databricks ACID).
- 그래서 메달리온은 이 원칙을 두 번 적용한 셈이다. 층으로 "검증된 것만 다음 층으로", 커밋으로 "끝난 것만 보이게".
소프트웨어 밖에서도 같은 경계
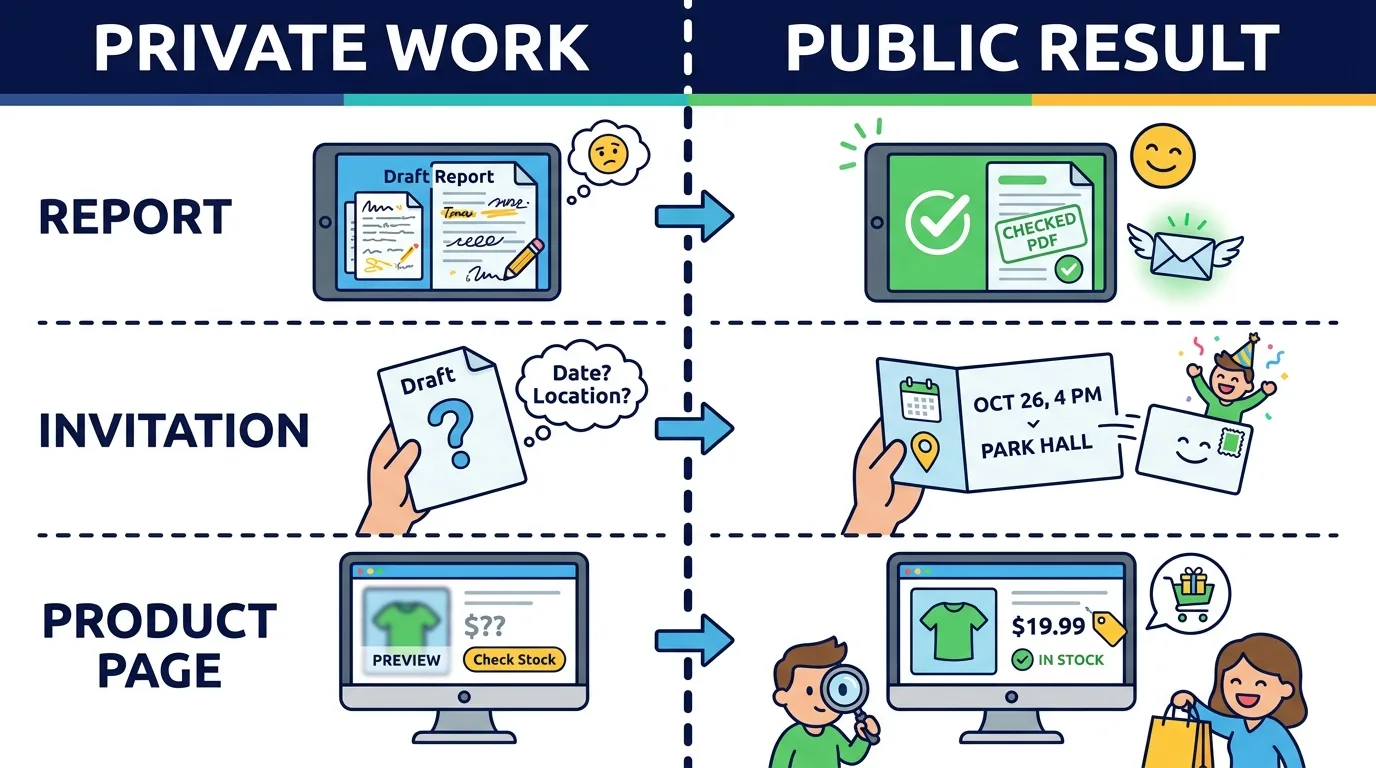
| 분야 | 작업 상태 | 공개 조건 |
|---|---|---|
| 보고서 | 임시 PDF | 쪽수와 필수 표 확인 |
| 행사 | 초대장 초안 | 장소와 시간 확인 |
| 상품 페이지 | 비공개 편집본 | 가격과 재고 확인 |
어느 경우든 만드는 사람의 진행 상황과 받는 사람이 결과를 쓸 수 있는 시점은 별개다. 시간 칸이 빈 초대장을 보냈다면 작업 중인 상태를 공개한 것이다. 손님은 이제 물어봐야 하고, 몇 명은 짐작으로 온다.
적용과 경계
어떤 작업이 이 원칙을 지키는지 확인하는 방법:
- 작업이 쓰는 곳을 전부 찾는다. 그중 독자가 여는 경로에 직접 쓰는 곳이 있는가?
- 단계마다 작업을 강제로 죽여 본다. 검증 전, 교체 직전, 교체 직후. 독자에게는 이전 완성본이나 새 완성본만 보여야 한다.
- 결과 하나가 여러 파일이라면, 파일을 하나씩 교체해서는 전체가 원자적이지 않다. 버전별 묶음을 만들고 하나의 공개 포인터를 바꾸거나, 트랜잭션을 쓴다.
이 원칙이 해결하지 않는 것도 있다.
- 두 작성자가 서로의 결과를 덮어쓰는 문제는 막지 못한다. 잠금이나 버전 검사가 따로 필요하다.
- 스트리밍은 계약이 다르다. 부분 상태를 보여주는 게 목적이고, 결과가 끝났다는 신호를 따로 정해야 한다.
- 검증은 검사한 것만 잡는다. "파일이 비어 있지 않다"만 확인하는 교체는, 비어 있지 않지만 틀린 파일을 그대로 공개한다.
한 문장으로 줄이면 이렇다. 독자가 여는 경로를 작업 공간으로 쓰지 마라.